8 小时出齐一本童书的插图
美国设计师 David W. Litwin 手里压着一本搁置了 20 多年的童书《Felicia Flitterkins》——故事早就写好,插图却始终没画。Midjourney 的 Style Tuner(风格调谐器)上线后,他决定试一次,结果 8 个小时出齐了全书插图,成本只有几美元。第二本书用上了更成熟的 v6 版本,只花了 6 小时。
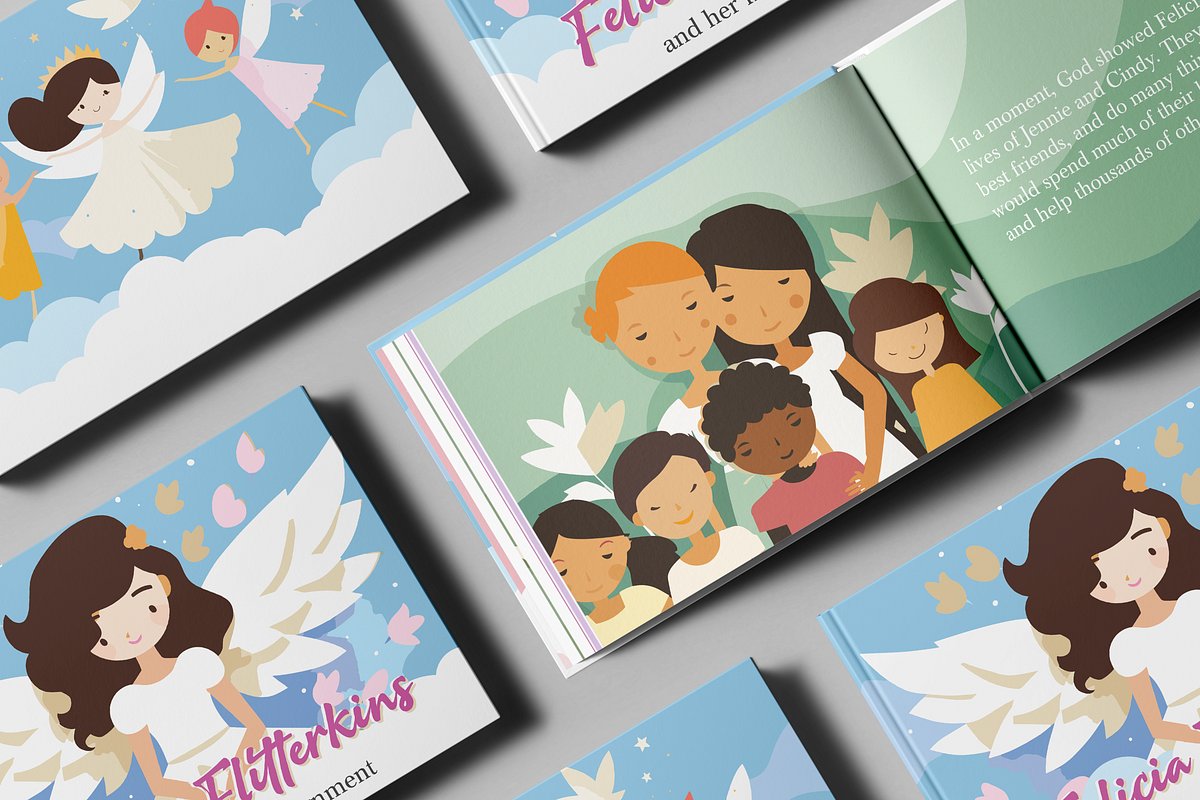
他的流程值得完整拆解:① 收集风格参考图;② 用 Style Tuner 反复比对,确定全书统一的视觉风格;③ 逐页出图;④ 用 Vary Region 局部重绘修改不满意区域;⑤ 用 TraceJourney 插件把位图矢量化并放大;⑥ 最后进 Adobe Illustrator 合成排版与精修配色。
更大的难题:角色一致性
童书最怕的不是画得慢,而是主角每页长得不一样。社区沉淀出三条主流方案:
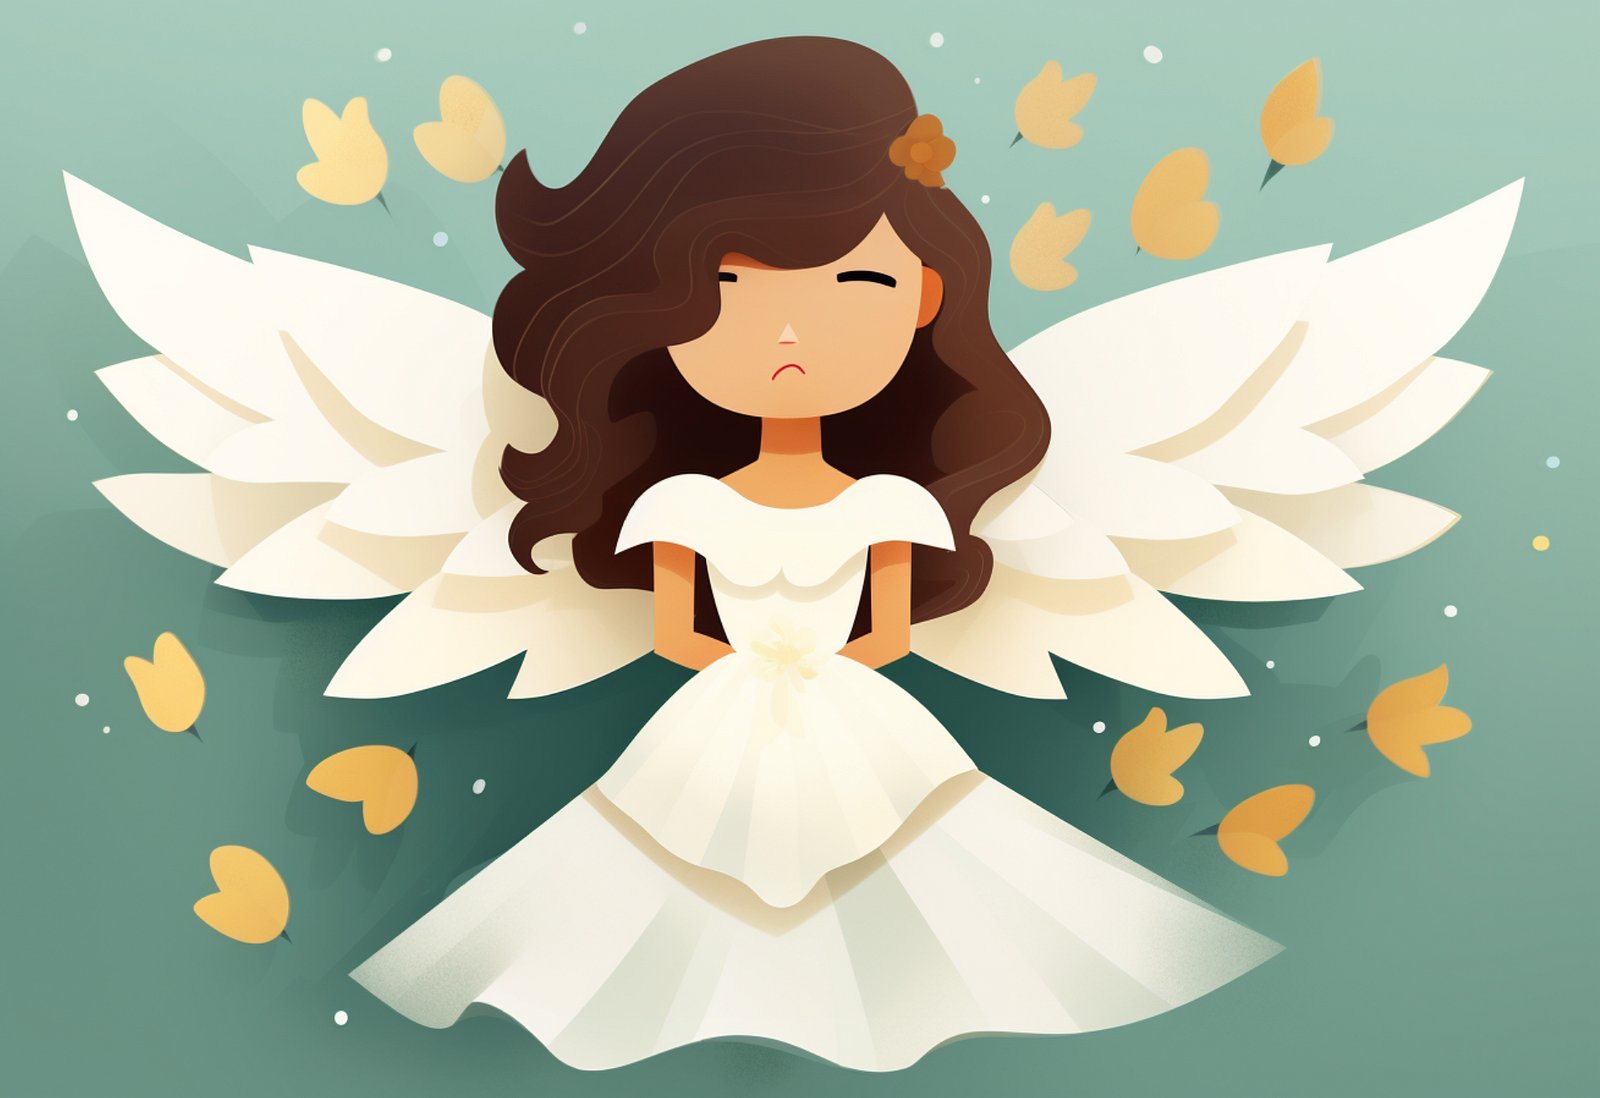
| Midjourney –cref | 上传主角「定妆照」,–cw 80 左右,一致度约 75-80% |
| SD 角色 LoRA | 用 12-15 张多角度图训练角色模型,一致度 95%+,云端训练约 0.5-1.5 美元/个 |
| 固定 seed + 身份前缀 | 每页提示词「焊死」角色描述,即梦可用 Agent 记忆、通义可用参考图(相似度 0.6-0.8) |
而「严格线稿上色」这条路上,Stable Diffusion 的 ControlNet lineart/canny 是技术基石:线稿强制跟随结构(Control Weight 0.7-1.0),再用 IP-Adapter 取色、LoRA 锁风格。完整的成书管线是:写故事 → 出定妆照 → 每页生成 → 从 60-100 张里挑 20 张 → Canva/稿定排版导出 PDF。
对婴童内容产品的启发
1. 个人也能做出版级内容。几美元、几小时,母婴自媒体、早教机构自制绘本的门槛已降到接近于零。
2. 「定妆照」思维可以迁移。不只是童书主角——品牌 IP 形象、系列产品的视觉锚点,都需要先定一张标准照再批量生成。
3. AI 出图 ≠ 成品。Litwin 流程里 Illustrator 合成、矢量化、排版仍占相当工作量,AI 负责生成,人负责成书。
资料来源:叶赛文编译 Litwin 案例(yesaiwen.com)、FlowPix AI 童书工作流、Dupple 教程、今日头条即梦/通义童书案例。